YouTube содержит огромное количество публичной информации, которая может поддерживать исследование контента, отслеживание конкурентов, анализ аудитории и маркетинговые исследования. Названия видео, описания, просмотры, комментарии, информация о каналах, даты загрузки и доступные расшифровки могут выявить полезные закономерности. Проблема в том, что сбор этой информации вручную становится нереалистичным, когда нужны данные из сотен или тысяч видео.
YouTube Scraper помогает превратить эту работу в структурированный процесс. Вместо того чтобы открывать каждое видео и копировать информацию в таблицу, инструмент скрапинга может собирать выбранные поля и сохранять их в формате CSV, JSON или другого формата. В зависимости от проекта пользователи могут выбрать no-code инструменты для скреплинга YouTube, API скраперов, библиотеки Python или официальный API данных YouTube.
Перед использованием любого метода важно понять правила YouTube. Политика разработчика API YouTube гласит, что клиенты API не должны скрейпинговать приложения YouTube или получать скрейпинг данных YouTube, за исключением случаев, когда правила YouTube это специально позволяют. Если нужная информация уже доступна через официальный API, обычно это первый вариант, который стоит проверить.
Если вы новичок в этом виде сбора данных, сначала может помочь разобраться в базовых концепциях веб-скрейпинга . Остальная часть этого руководства посвящена тому, как работает YouTube Scraper , какие инструменты полезны в 2026 году, как собирать разные типы данных YouTube и какие проблемы стоит ожидать.
Что такое YouTube-скрейпер и какие данные он может извлечь?
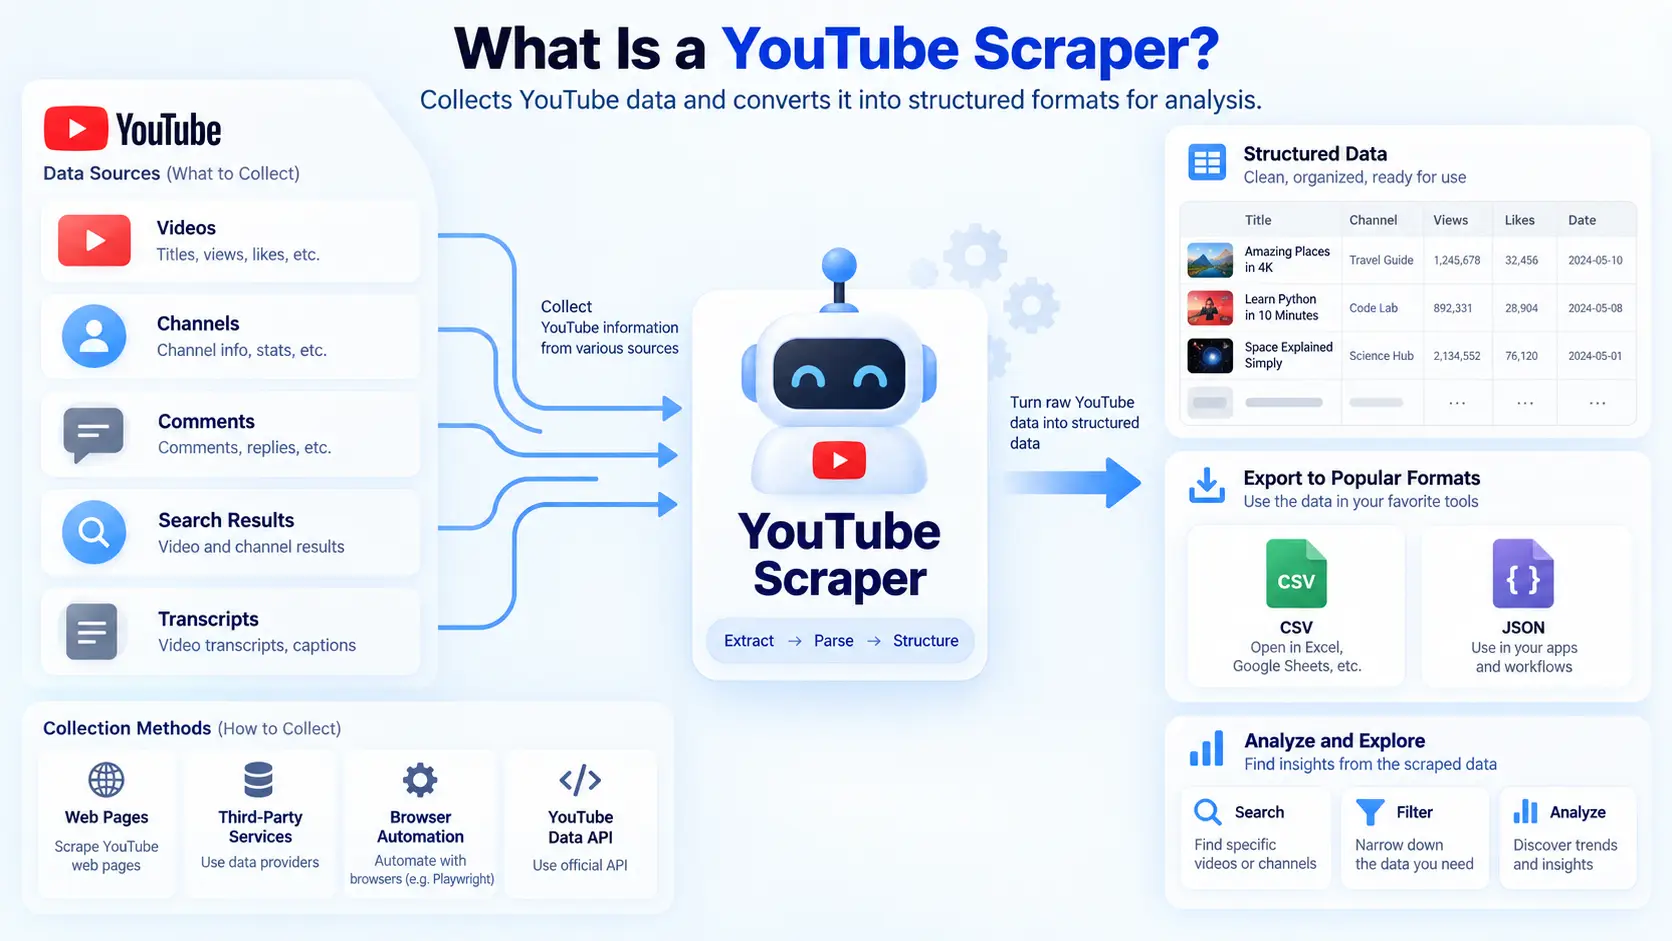
YouTube Scraper — это инструмент или скрипт, который собирает информацию, связанную с видео, каналами, комментариями, результатами поиска или расшифровками на YouTube. Собранные данные обычно преобразуются в структурированный формат, чтобы их можно было искать, фильтровать или анализировать. Это может значительно сэкономить время, если проект содержит больше данных, чем человек мог бы разумно скопировать вручную.
Не каждый скрейпер работает одинаково. Некоторые инструменты читают информацию с веб-страниц YouTube, другие используют сторонние сервисы или автоматизацию браузеров. Официальный API данных YouTube использует другой подход, предоставляя разработчикам документированный доступ к поддерживаемым ресурсам YouTube.
Как работает скрепер на YouTube
Большинство рабочих процессов YouTube Scraper начинаются с ввода. Этот ввод может быть URL видео, URL канала, плейлист, ключевое слово или список идентификаторов видео. Затем скрепер ищет конкретные поля, извлекает значения и сохраняет их в структурированном результате.
Представьте, что маркетинговая команда хочет изучить 300 видео о инструментах для написания ИИ. Открытие каждого видео вручную займёт часы, и команда легко может пропустить детали или неправильно скопировать цифры. Скрепер может собирать поля, такие как название видео, название канала, дата публикации, просмотры, лайки, описание и идентификатор видео в одном повторяемом рабочем процессе.
Некоторые инструменты для скрепления YouTube работают через сам сайт. Другие используют API для запроса структурированных данных. Например, официальный API данных YouTube предоставляет эндпоинты для видео, каналов, плейлистов, комментариев и потоков комментариев. Метод videos.list может возвращать поля, такие как заголовок, описание, идентификатор канала, теги и статистику, когда эти части запрашиваются.
Разница важна, потому что инструменты на основе страниц зависят от того, как строятся страницы YouTube. Если YouTube меняет структуру страницы или внутренний поток данных, возможно, потребуется обновить скрейпер. Методы на основе API обычно возвращают более чистые структурированные данные, но у них есть квоты, права и правила платформы.
Какие данные с YouTube можно собрать?
Тип данных, которые вы можете собрать, зависит от инструмента. Для видеоисследований распространённые поля включают заголовки видео, описания, URL-адреса, видео ID, названия каналов, даты публикации, продолжительность, просмотров, лайков, количество комментариев, теги и категории. Эти поля могут поддерживать анализ контента, исследование тем и мониторинг конкурентов.
Комментарии — ещё одна распространённая цель. Скрейпер комментариев на YouTube может собирать текст комментариев, имена пользователей, даты, количество лайков, количество ответов и идентификаторы комментариев. Официальная commentThreads.list конечная точка также может возвращать потоки комментариев и поддерживает страницирование, когда появляются новые результаты.
Эти данные могут быть полезны в реальном маркетинговом проекте. Например, софтверная компания может собрать комментарии из нескольких обзорных видео о собственном продукте и конкурирующих инструментах. Затем команда может искать повторяющиеся жалобы, такие как высокие цены, сложная настройка, отсутствующие функции или плохая поддержка, что может выявить проблемы продукта, не очевидные только по просмотрам.
Транскрипты могут предоставить дополнительный уровень информации. Скрейпер транскриптов на YouTube может превращать доступные субтитры в поисковый текст, что облегчает изучение того, что авторы действительно обсуждают внутри видео. Это может помочь в исследовании ключевых слов, поиске тем, анализе контента конкурентов и масштабной классификации текста.
Доступ к расшифровке менее предсказуем, чем базовые метаданные. Некоторые видео не имеют субтитров, некоторые используют автоматически сгенерированные субтитры, а некоторые методы транскрипции зависят от неофициальных интерфейсов. Также следует учитывать авторские права и разрешённое использование перед хранением или повторной публикацией большого количества текста расшифровки.
YouTube Scraper против YouTube API
YouTube Scraper и YouTube Data API иногда могут собирать похожую информацию, но это не один и тот же тип инструмента. Официальный API обеспечивает документированный доступ к поддерживаемым ресурсам YouTube и обычно проще проверять, поскольку поля и методы запроса чётко определены. Это хорошая отправная точка, когда вашему проекту нужны только данные, которые YouTube уже предоставляет через свой API.
Квота — это один из факторов, которые стоит учитывать. Google в настоящее время указывает, что videos.list стоимость одной единицы квоты за запрос, а commentThreads.list также одна единица. Проекты, использующие API данных YouTube, обычно получают ежедневную квоту, и некоторые методы используют гораздо больше единиц, чем простые запросы списка.
Сторонний API для скрепера YouTube может быть удобнее, если вам нужна готовая система, которая обрабатывает запросы, повторные проверки, парсинг данных и экспорт. Это может сократить время разработки, особенно когда данные нужно напрямую перемещать в базу данных или аналитический инструмент. Компромисс в том, что вы зависите от ценообразования, поддерживаемых полей и обслуживания другого провайдера.
Лучший выбор зависит от проекта, а не от названия инструмента. Если официальный API уже предоставляет нужные вам видеостатистики, возможно, нет смысла создавать отдельный скрейпер. Если вашему рабочему процессу нужна другая структура вывода, взаимодействие с браузером или другой поддерживаемый метод сбора, сторонний инструмент может быть проще в управлении.
Лучшие инструменты для скрепера на YouTube в 2026 году
Не существует единого YouTube-скрейпера , который лучше всего подходит каждому пользователю. Маркетолог, собирающий комментарии из 20 видео, имеет совершенно другие потребности от разработчика, обрабатывающего сотни тысяч записей. Правильный выбор зависит от объёма данных, типа данных, ваших технических навыков, формата вывода и частоты выполнения задачи.
Для большинства пользователей основной выбор — между инструментами без кода, API скрейперов и инструментами на основе Python. Каждый вариант может хорошо работать, если соответствует размеру и сложности проекта. Обычно лучше сначала протестировать небольшой выборку, чем выбирать инструмент только потому, что он поддерживает очень крупные задачи.
Инструменты для скрапинга на YouTube без кода
Инструменты для скрапинга на YouTube без кода полезны маркетологам, исследователям и контент-командам, которые не хотят создавать собственные скрипты. Обычно такие инструменты предоставляют форму или дашборд, где пользователи добавляют URL-адреса видео, выбирают поля данных, устанавливают лимиты и запускают задачу. Результаты затем можно скачать или отправить в другой сервис.
Один из примеров — YouTube Comments Scraper от Apify. Пользователи могут добавлять один или несколько URL видео, ограничивать количество собранных комментариев, сортировать комментарии и экспортировать результаты в форматы, такие как JSON, CSV или Excel. В настоящее время инструмент собирает информацию, такую как текст комментариев, имена пользователей, даты публикации, количество лайков и ответы.
Такая схема хорошо подходит для исследования аудитории. Предположим, что бренд электронной коммерции хочет изучить комментарии из 40 видео с обзорами товаров. Вместо того чтобы читать тысячи комментариев по одному, команда может собрать их в одном наборе данных и искать повторяющиеся вопросы, жалобы или проблемы по покупке.
Bright Data также предоставляет API для YouTube Scraper, который можно использовать через панель управления без создания полной системы сбора с нуля. Текущий продукт поддерживает видео, каналы, комментарии и структурированный вывод в форматах, таких как JSON, NDJSON и CSV. В настоящее время сервис рекламирует бесплатное разрешение в размере 5 000 записей в месяц, хотя цены и ограничения могут меняться.
Для тех, кто хочет более широкую опцию сбора данных на базе браузера, DICloak также предоставляет AI-краулер для веб-скрейпинга. Он позволяет пользователям предоставлять страницу и инструкции по задаче вместо того, чтобы строить весь рабочий процесс из кода. В собственной документации DICloak эта функция описывается как безкодовый краулер, который может организовывать извлеченную информацию в структурированный вывод.
API для скрепера на YouTube
YouTube Scraper API часто лучше подходит, когда собранные данные нужно напрямую перенести в другую систему. Вместо ручной загрузки файла разработчик может отправить запрос, получить структурированные данные и хранить их в базе данных или аналитическом конвейере. Это облегчает автоматизацию повторяющихся заданий.
Сначала следует проверить официальный API данных YouTube. Разработчик может хранить список видео ID и использовать videos.list их для запроса обновлённой публичной информации по расписанию. Другой процесс может быть commentThreads.list использован для сбора веток комментариев к выбранным видео.
API сторонних скреперов могут уменьшить объём инфраструктуры, необходимой для поддержания команды. Текущий API YouTube Scraper от Bright Data принимает целевые URL и возвращает структурированные записи, а также поддерживает вызовы API, вебхуки и облачную доставку. На странице продукта в настоящее время перечислены Python, Node.js, HTTP-запросы и несколько форматов доставки.
API scraper особенно полезен, когда проект запускается многократно. Например, система мониторинга бренда может ежедневно проверять выбранные YouTube-каналы и отправлять новые записи во внутреннюю панель управления. Разработчику всё равно нужно проверить результаты, но этап сбора данных становится проще для подключения к остальной части приложения.
Python YouTube-скрейперы
Python полезен, когда нужно больше контроля над рабочим процессом сбора и обработки. Python-скрейпер на YouTube можно подключить к базе данных, комбинировать с анализом текста или запланировать работу в регулярное время. Основной минус в том, что решения на Python обычно требуют больше обслуживания, чем управляемый сервис.
Для проектов с транскриптами youtube-transcript-api — хорошо известный пример. В текущей документации говорится, что компания может получать ручные и автоматически сгенерированные транскрипты, работать с разными языками, переводить поддерживаемые транскрипты и возвращать структурированные данные транскриптов. Для базового рабочего процесса транскриптов не требуется официальный ключ YouTube Data API.
Тот же проект также даёт важное предупреждение. Он использует недокументированную часть веб-клиента YouTube, поэтому нет гарантии, что метод продолжит работать, если YouTube изменит интерфейс. Это делает его полезным для некоторых проектов, но также означает, что разработчикам стоит ожидать периодических сбоев и обновлений.
Ещё один популярный технический инструмент — yt-dlp. Он может извлекать широкий спектр видеоинформации, но недавние изменения на YouTube сделали некоторые рабочие процессы более сложными. Проект yt-dlp в настоящее время документирует растущее использование YouTube Proof of Origin, или PO Tokens, и отмечает, что некоторые форматы и функции могут не работать без них.
Это полезное напоминание для всех, кто создаёт кастомный YouTube Scraper. Скрипт, который работает сегодня, может не работать вечно, даже если сам код не изменился. YouTube может менять структуру страниц, правила запроса, требования к токенам и внутренние конечные точки, поэтому обслуживание должно быть частью плана с самого начала.
Как пользоваться скрепером на YouTube
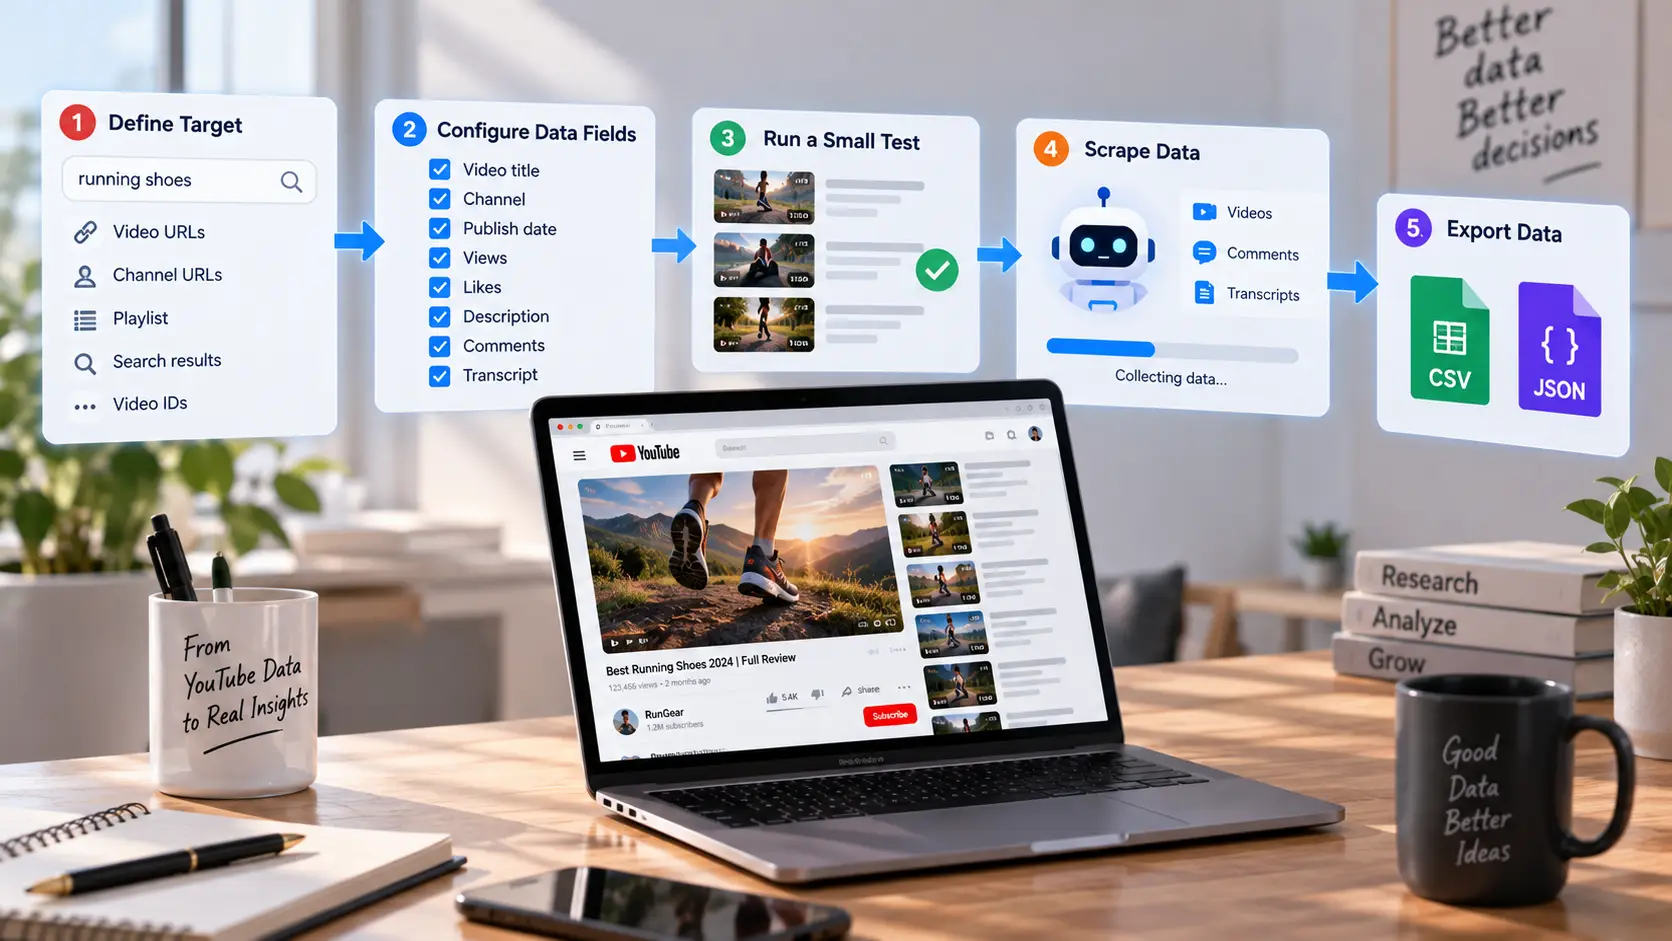
Успешный проект по скрапингу обычно начинается с чёткого вопроса, а не с большого списка URL. Если вы не знаете, чему хотите научиться, легко собрать большие объёмы данных, которые так и не будут использованы. Определение цели сначала также облегчает выбор правильного YouTube-скрейпера и правильных полей данных.
Начинайте с малого, даже если ваш инструмент может обрабатывать тысячи записей. Небольшой тест облегчает выявление отсутствующих полей, неправильных форматов, дублирующихся записей или неожиданных результатов. Когда данные теста выглядят корректно, вы сможете увеличить объём работы с гораздо большей уверенностью.
Настройте и настройте свой YouTube-скрейпер
Первый шаг — определить цель. Представьте, что вы хотите изучить видео на YouTube о беговых кроссовках, опубликованных за последние шесть месяцев. Вы можете начать со 100 URL видео, нескольких URL каналов или списка идентификаторов видео, собранных в результатах поиска.
Далее решите, какая информация действительно необходима. Если цель — исследование контента, название видео, канал, дата публикации, просмотров, лайков, описание и URL могут быть достаточными. Если цель — исследование клиентов, вам также могут понадобиться комментарии, количество ответов или текст расшифровки.
Проведите небольшой тест перед сбором всего. Обычно достаточно десяти видео, чтобы проверить, правильны ли поля и нет ли каких-либо данных. Откройте несколько оригинальных страниц на YouTube и сравните видимую информацию с собранными записями, прежде чем доверять большому набору данных.
Этот шаг может показаться медленным, но он предотвращает серьёзные проблемы в будущем. Если формат даты на десяти пластинках неверен, это легко исправить. Если та же проблема возникает после сбора 200 000 записей, очистка становится значительно дороже.
Скапингуйте видео, комментарии и расшифровки с YouTube
Метаданные видео обычно являются самым простым для сбора данных на YouTube. Официальный videos.list метод может возвращать поддерживаемую информацию через поля, такие как snippet, statistics, и contentDetails. Это делает его полезным для проектов, сравнивающих названия видео, дат, показатели вовлечённости и другие публичные атрибуты.
Комментарии требуют дополнительного планирования, потому что популярные видео могут содержать тысячи ответов. Официальная commentThreads.list конечная точка поддерживает пагинацию, а большие разделы комментариев могут требовать нескольких запросов. Если нужны индивидуальные ответы, comments.list эндпойнт также можно использовать для поддерживаемых записей комментариев.
Скрепер комментариев на YouTube может упростить этот рабочий процесс, если цель — исследование, а не разработка API. Например, маркетинговое агентство может собирать комментарии из видео с обзорами продукта и группировать их по распространённым вопросам, положительным и отрицательным отзывам. Анализ может выявить, почему зрителям нравится один продукт, а другой отвергает.
Расшифровки обычно должны рассматриваться как отдельная задача. Скрейпер транскриптов на YouTube может помочь преобразовать доступные субтитры в структурированный текст для изучения ключевых слов, анализа тем или внутренних исследований. Однако пользователям следует проверять как доступность, так и разрешённое использование транскриптов перед хранением или повторным использованием большого количества защищённого авторским правом контента.
Экспортировать данные YouTube в CSV или JSON
После того как вы собираете данные с YouTube, формат вывода должен совпадать с тем, что происходит дальше. CSV хорошо работает, когда данные плоские и открываются в Excel, Google Sheets или другом инструменте таблиц. Легко отсортировать видео по дате, просмотрам, каналу или вовлечённости и поделиться файлом с нетехническими членами команды.
JSON часто лучше подходит разработчикам. Он может хранить вложенную информацию, что полезно, когда одно видео содержит несколько связанных полей или комментарий содержит ответы. JSON также естественно вписывается в API, базы данных и автоматизированные конвейеры обработки.
Стабильные идентификаторы важны в обоих форматах. Заголовок может меняться, и два видео могут иметь одинаковое название, но видео ID даёт более надёжный ключ. Та же идея применима к идентификаторам каналов и комментариев, когда они доступны.
Также полезно сохранять дату сбора или отметку времени. Сегодня видео может набрать 25 000 просмотров и 80 000 просмотров в следующем месяце, поэтому это число мало имеет значения без знания, когда оно было собрано. Хорошее извлечение данных с YouTube сохраняет и ценность, и контекст.
Распространённые проблемы и риски скрепера на YouTube
Даже сильный YouTube Scraper может давать неполные результаты или перестаёт работать. Иногда скрепер сломан, но иногда исходные данные меняются или исчезают. Понимание разницы значительно ускоряет устранение неполадок.
Надёжность — это не только поддержка скрипта. Вам также нужно знать, являются ли данные полными, актуальными и собранными в соответствии с правилами, применяемыми к платформе и вашему проекту. Это особенно важно, когда результаты будут использоваться для бизнес-решений.
Почему скреперы YouTube перестали работать
Инструменты для скрапинга на YouTube на основе страниц зависят от структуры страниц YouTube и внутренних запросов. Если YouTube меняет способ загрузки значения, скрепер может перестать находить то же поле. Это может происходить даже тогда, когда URL и видимая страница выглядят почти одинаково.
Неофициальные библиотеки сталкиваются с похожей проблемой. В проекте youtube-transcript-api чётко указано, что это зависит от недокументированного интерфейса, используемого веб-клиентом YouTube. Если YouTube изменит этот интерфейс, инструмент может временно перестать работать до обновления проекта.
Технические изменения также могут повлиять на инструменты для извлечения видео. Проект yt-dlp в настоящее время документирует более широкое применение PO Token для некоторых запросов на YouTube и предупреждает, что некоторые функции могут быть недоступны без необходимого токена. Это показывает, почему инструменты скрапинга требуют регулярных обновлений, а не рассматриваются как постоянные скрипты.
Не каждый пропущенный результат — это технический сбой. Видео могло стать закрытым, комментарии отключены или субтитры могут не существовать. Перед изменением кода проверьте, предоставляет ли исходный источник ту информацию, которую вы ожидали.
Как повысить точность и стабильность скребка
Самый простой способ повысить точность — проверить небольшой выборку вручную. Сравните несколько скрейпинг-записей с оригинальными страницами YouTube или официальными ответами API. Если цифры или текст не совпадают, определите причину, прежде чем увеличивать размер работы.
Сохраняйте как исходный результат, так и очищенную версию. Обработка данных может привести к ошибкам, особенно когда скрипты меняют даты, удаляют дубликаты, переводят текст или объединяют несколько полей. Сохранение исходного ответа даёт вам что-то, к чему можно вернуться, когда следующий шаг приносит неожиданные результаты.
Крупные задания также должны фиксировать неудачные цели, а не игнорировать их безмолвно. Если вы отправляете 10 000 видеоID и получаете 9 600 записей, недостающие 400 должны храниться в журнале неудач. В противном случае ваш итоговый набор данных может выглядеть полным, даже если важная группа видео отсутствует.
Для повторяющихся проектов отделяйте сбор от анализа. Сначала соберите и сохраните исходные данные, затем выполните очистку, классификацию, анализ настроений или отчётность как второй шаг. Это значительно облегчает определение, возникла ли проблема в YouTube Scraper или из вашего собственного кода обработки.
Ограничения и соблюдение требований по скрапингу на YouTube
Скрейпинг на YouTube имеет технические ограничения, но также имеет ограничения политики. Политика разработчиков API YouTube гласит, что клиенты API не должны напрямую или косвенно скрейпинговать приложения YouTube или получать скрапированные данные YouTube. Разработчики, использующие официальный API, также должны следовать условиям API YouTube, правилам конфиденциальности, требованиям безопасности и политике обработки данных.
Конфиденциальность заслуживает особого внимания, когда речь идёт о комментариях или пользовательской информации. Руководство для разработчиков YouTube говорит, что клиенты API не должны собирать и хранить идентифицирующую информацию пользователей без согласия и должны уважать конфиденциальность пользователей. Сбор только тех полей, которые действительно необходимы, может снизить риски и ненужное хранение данных.
Например, для исследования настроений может понадобиться только текст комментариев, дата и информация о вовлечении. Возможно, не нужно хранить имя пользователя в течение нескольких месяцев. Вопрос, действительно ли каждое поле необходимо, — простой способ построить более чистый исследовательский рабочий процесс.
Транскрипты требуют аналогичной осторожности. Публично видимые субтитры всё равно остаются контентом, и сбор текста для внутреннего анализа темы отличается от копирования полных расшифровок и их повторной публикации в других местах. Надёжный рабочий процесс YouTube Scraper должен учитывать техническую точность, правила платформы, конфиденциальность и авторские права вместе.
Улучшите скрепинг на YouTube с помощью DICloak
Для некоторых команд сбор данных — лишь одна часть проблемы. Им также может понадобиться управление разными сессиями браузера, настройками прокси, клиентскими проектами и скриптами автоматизации, не смешивая всё вместе. В таких случаях организация браузера может быть столь же важна, как и сам скрейпер.
DICloak может выступать в роли слоя управления браузером для одобренных рабочих процессов с данными. Его основная ценность здесь — не заменить API данных YouTube или изменить правила YouTube. Он предоставляет профили браузера, конфигурацию прокси и инструменты локального API, которые помогают поддерживать организацию различных браузерных проектов.
Если изоляция браузера — часть вашей исследовательской системы, это руководство по антидетектирующему браузеру для веб-скрейпинга объясняет, как отдельные профили браузера могут вписаться в более крупные рабочие процессы с данными. Та же идея может быть полезна, когда нескольким проектам или членам команды нужны собственные настройки и сессии.
Отдельные задачи скрейпинга с профилями браузера
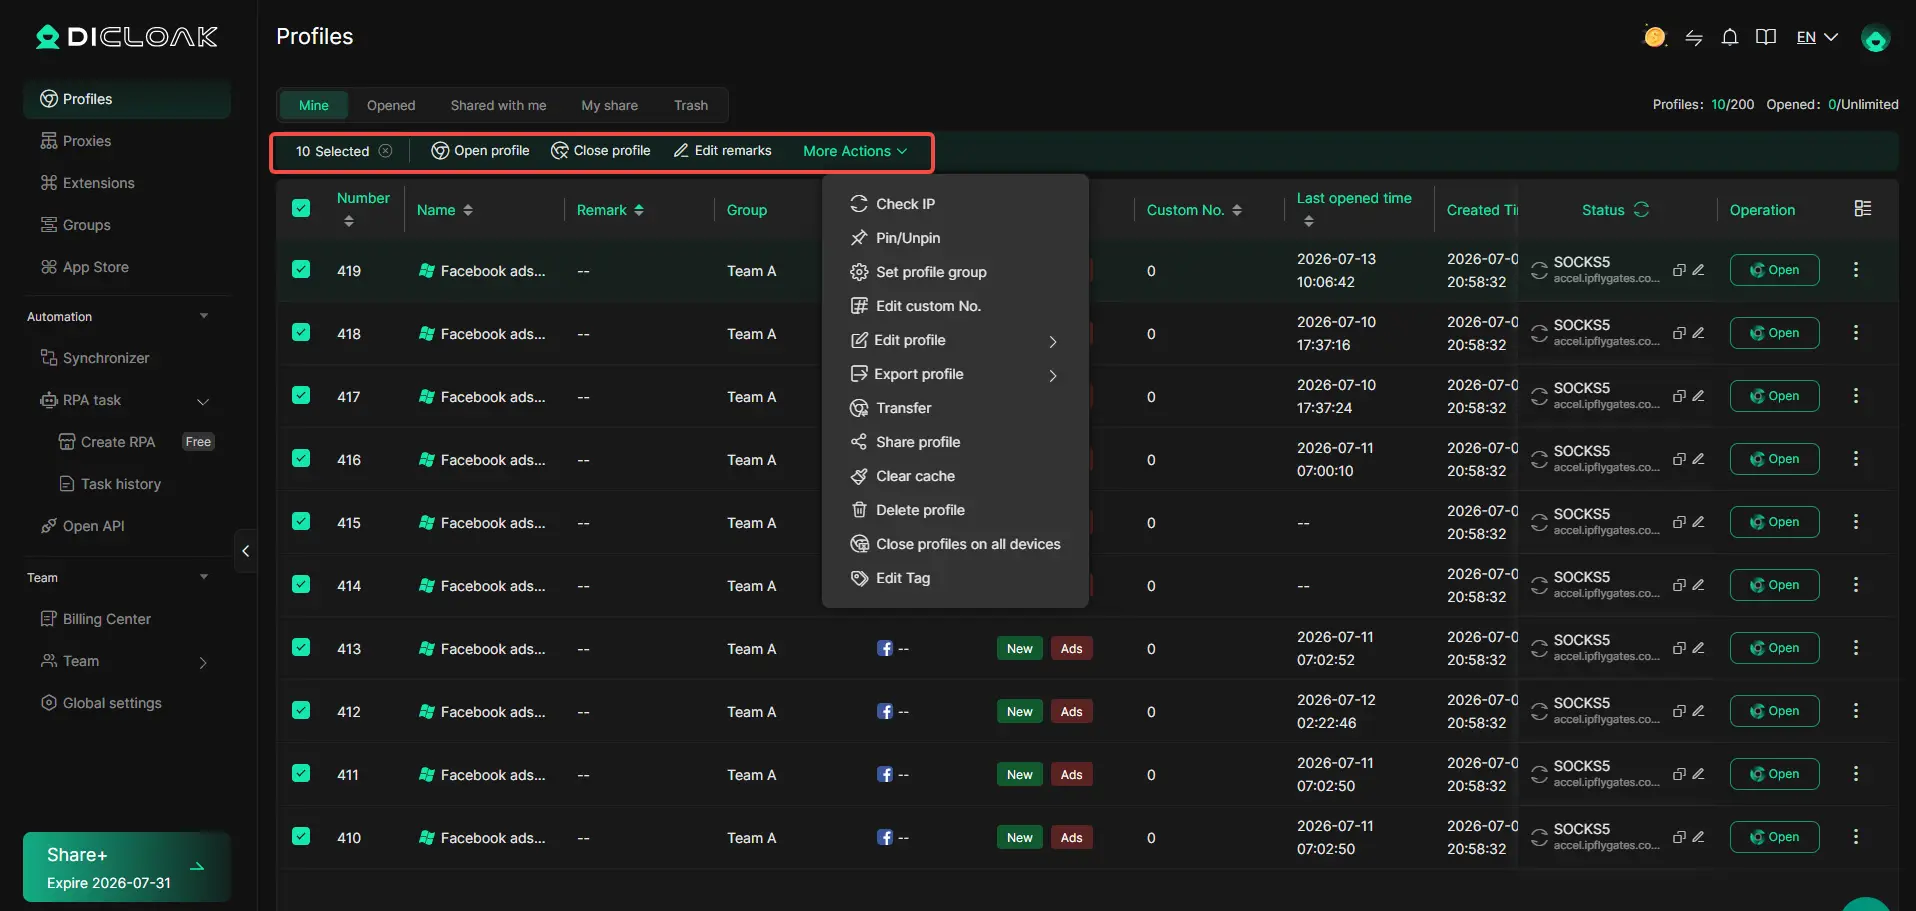
DICloak использует отдельные профили браузера для организации данных и настроек браузера. Его локальный API может отображать профили браузера и фильтровать их по информации, такой как группа, тип прокси, хост прокси, выходной IP, статус и платформа. Это даёт командам более понятный способ отделить один исследовательский проект от другого.
Например, исследовательская группа может использовать один профиль браузера для проекта по анализу конкурентов, а другой — для тестирования браузерного инструмента данных. Отдельный профиль может быть назначен клиентскому проекту, чтобы куки, сессии и настройки браузера не смешивались с несоответствующей работой.
Этот подход также полезен, когда над одним исследовательским процессом работает более одного человека. Вместо того чтобы открывать каждую задачу в одном обычном браузере, каждый проект может иметь свой собственный профиль и настройки. Преимущество — более чистая организация, а не более агрессивный сбор данных.
Настройте прокси для скрапинга на YouTube
DICloak поддерживает различные режимы прокси на уровне профиля браузера. В текущей документации перечислены функции No Proxy, Custom Proxy, Saved Proxies и API, а Local API поддерживает типы прокси, такие как HTTP, HTTPS и SOCKS5.
Это помогает командам привязывать сетевые настройки к правильному проекту. Например, одна исследовательская задача в браузере может использовать корпоративное сетевое соединение, а другой одобренный региональный проект — определённую конфигурацию прокси. Хранение этих настроек в отдельных профилях облегчает избегание случайных изменений конфигурации.
Для пользователей, которым нужен дополнительный справочник, контент DICloak о рабочих процессах прокси и веб-скрейпинга охватывает такие темы, как инфраструктура скрейпинга и производительность сети. Прокси всё равно следует рассматривать как сетевой инструмент, а не как способ игнорировать ограничения платформы.
То же правило применяется и к YouTube-скрейперу. Изменение пути сети не меняет политики YouTube, правила авторских прав или обязательства по конфиденциальности. Цель должна заключаться в стабильной и организованной инфраструктуре для разрешённых задач.

Интегрируйте DICloak с Python и API
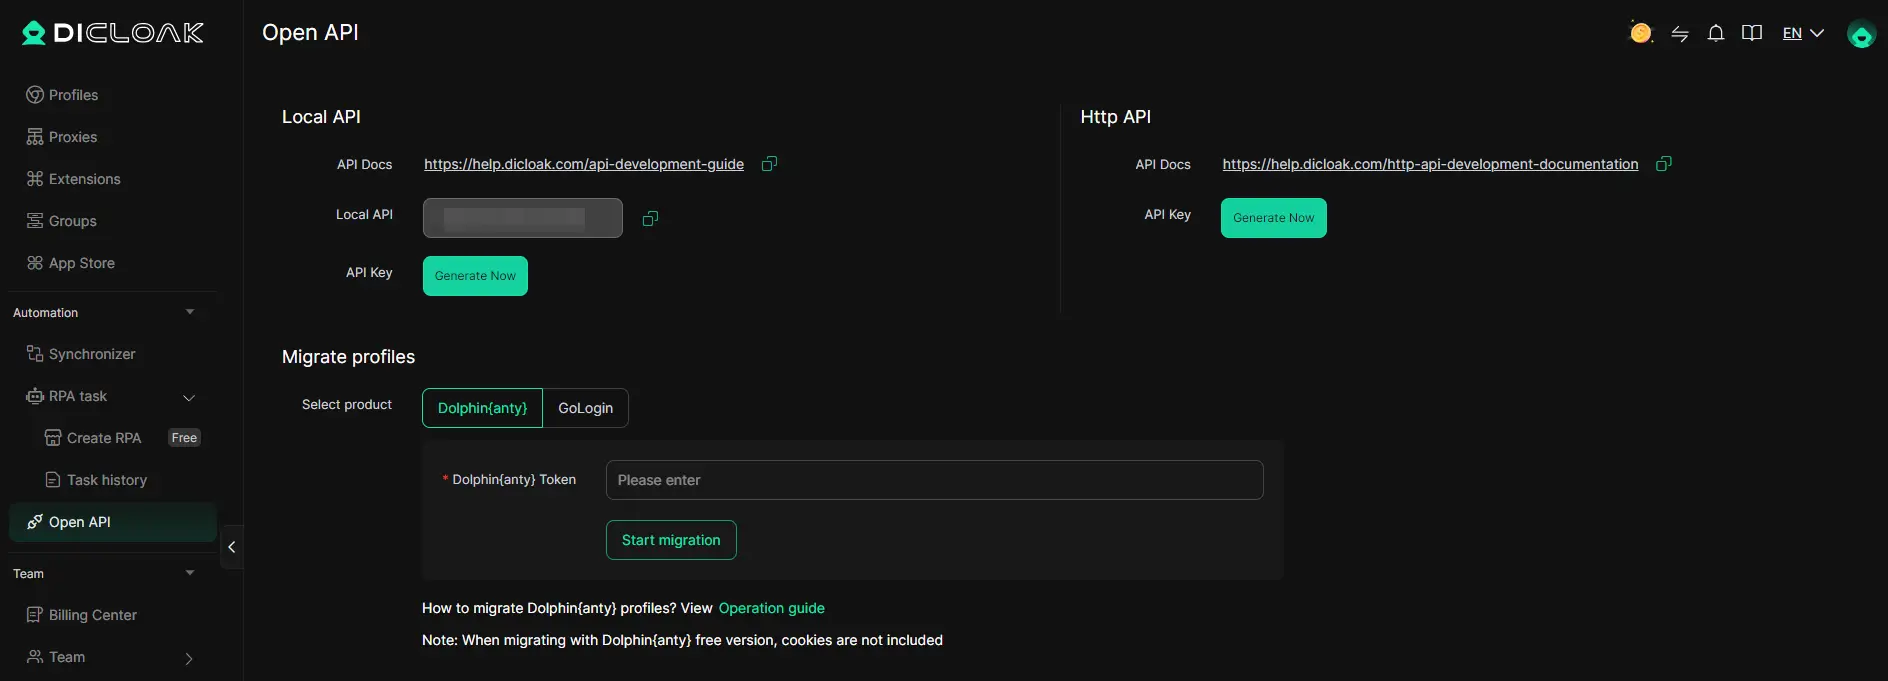
Технические команды могут подключать DICloak к собственной автоматизации через Local Open API. Текущее руководство по разработке включает примеры для Python с Playwright и ChromeDriver, Node.js с Puppeteer и Java с ChromeDriver. Также документируются действия, такие как перечисление профилей браузера, их открытие, подключение инструментов автоматизации, взаимодействие с окнами браузера и закрытие сессий.
Это может вписаться в более широкий рабочий процесс на Python, когда требуется взаимодействие с браузером. Скрипт может запросить конкретный профиль браузера через локальный API, открыть этот профиль, подключить Playwright, выполнить одобренную задачу браузера, сохранить результат и закрыть профиль. Обработка данных может продолжаться на Python без включения логики управления браузером в каждый этап.
API Browser Profile API и интерфейс прокси DICloak также позволяют программно читать конфигурацию профилей и сети. Это помогает большим командам поддерживать согласованность правил именования, группировки, назначения прокси и автоматизации во многих проектах.
Самая надёжная настройка обычно — это многоуровневая. Используйте официальный YouTube Data API, когда он уже предоставляет нужную информацию, выбирайте подходящий YouTube Scraper API или другой разрешённый инструмент, если проект требует другого рабочего процесса, и используйте Browser Profiles только тогда, когда браузерная работа действительно нуждается. Это делает процесс более проще для тестирования, проще в обслуживании и гораздо более понятным для команды.
Часто задаваемые вопросы о YouTube Scraper
Вопрос 1: Что такое YouTube Scraper?
YouTube Scraper — это инструмент или скрипт, который собирает публичные данные с YouTube, такие как названия видео, описания, просмотры, комментарии, информацию о каналах, даты публикации и доступные расшифровки. Данные затем можно сохранять в форматах, таких как CSV или JSON, для исследований, анализа или отчетности.
Вопрос 2: Какие данные может собирать YouTube Scraper?
YouTube Scraper может собирать разные типы данных в зависимости от инструмента. Распространённые примеры включают метаданные видео, информацию о каналах, комментарии, количество ответов, результаты поиска, плейлисты, данные о вовлечённости и транскрипты. Некоторые инструменты для скрапинга на YouTube также позволяют пользователям выбирать только необходимые поля.
Вопрос 3: Является ли YouTube Scraper тем же же, что и API данных YouTube?
Нет. YouTube Scraper может собирать информацию с веб-страниц, автоматизации браузера или сторонних сервисов скрейпинга, в то время как API YouTube Data предоставляет официальный и документированный доступ к поддерживаемым данным YouTube. Если нужная информация доступна через официальный API, обычно стоит сначала проверить эту опцию.
Вопрос 4: Может ли YouTube Scraper собирать комментарии и расшифровки?
Да, некоторые инструменты YouTube Scraper могут собирать комментарии, ответы и доступные расшифровки. Скрепер комментариев на YouTube может помочь с исследованием аудитории или настроений, а скрепер для расшифровок на YouTube может превратить доступные субтитры в структурированный текст. Однако комментарии могут быть отключены, и некоторые видео могут не содержать расшифровок.
Вопрос 5: Как выбрать лучший YouTube Scraper в 2026 году?
Выбирайте YouTube-скрейпер , исходя из необходимых данных, количества видео, которые планируете обрабатывать, ваших технических навыков и предпочитаемого формата вывода. Инструменты без кода проще для новичков, API скрепера хорошо работают для автоматизированных рабочих процессов, а инструменты на Python дают больше контроля. Также стоит учитывать точность данных, обслуживание, правила YouTube и возможность экспортировать данные в CSV, JSON или вашу базу данных.
 Бесплатные инструменты
 Плагин Cookie
 Генератор UA
 Генератор MAC-адресов
 Генератор IP-адресов
 Список IP-адресов
 Генератор кода 2FA
 Мировые Часы
 Проверка анонимности
 WebRTC Leak Test
 Генератор UUID
 Проверка прокси
 Проверка FB Рекламы
 AI-веб-скрейпинг
 Бесплатные SMM-инструменты
 Проверщик теневой блокировки Twitter
 Проверка имени в Instagram
 UTM-генератор
 Генератор username
 AI генератор хэштегов
 Генератор заголовков LinkedIn
 Размер изображений для соцсетей


