Вы вводите подсказку, Codex выдает пять строк сломанного Python, и вдруг ваш ежедневный рабочий процесс становится медленнее, чем год назад. Если вы заметили, что Codex стал глупее в тех задачах, которые раньше отлично выполнял, например, в написании простых скриптов или исправлении простых ошибок, вы не одиноки. Жалобы на снижение производительности кодекса и качество кодирования повсюду, но никто не даёт чёткого ответа на то, что именно изменилось.
Некоторые говорят, что это просто ваше воображение или что подсказки стали менее аккуратными, но это не соответствует шаблону. Воспроизводимые регрессии появляются даже в хорошо задокументированных кодовых базах. Риск — это не просто мелкое раздражение: если вы зависите от Codex для производственного кода, даже небольшое снижение точности предложений может привести к часам ручной отладки или пропущенных дедлайнов.
Настоящая история — это не столько в исходном размере модели, сколько в изменениях в обучающих данных, политиках выравнивания и в том, как Codex обновляется за кулисами. Изменения, направленные на повышение безопасности или более общего ИИ, часто исключают те крайние случаи, которые раньше делали Codex действительно полезным для опытных пользователей. Если вы видите более обобщённые, менее полезные ответы — это не воображение, регрессия моделей — это реальная и отслеживаемая проблема для разработчиков.
Так что же на самом деле вызывает потерю качества и что с этим можно сделать? Вот где начинают проявляться проблемы.
Почему так много пользователей говорят, что Codex стал глупее в 2026 году?
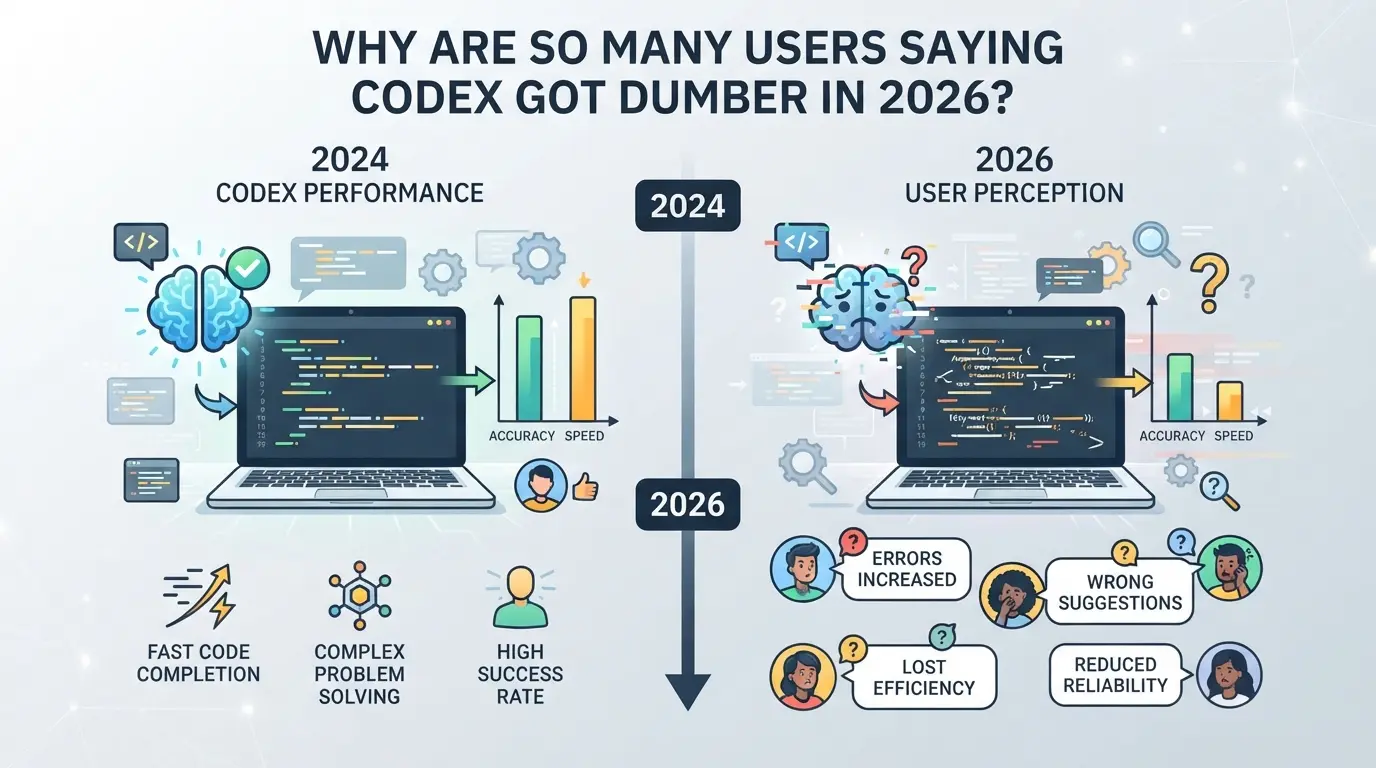
Жалобы на качество кода в Codex не просто громче, они исходят от опытных разработчиков, которые полагались на чёткие, контекстно-ориентированные рекомендации. Теперь пользователи сообщают о более универсальных завершениях, неактуальном коде и даже старых багах, исправленных в предыдущих версиях.
Распространённые жалобы: что сообщают пользователи
Люди отмечают, что Codex забывает недавний контекст в многофайловых проектах, неправильно называет переменные и повторяет блоки кода, которые не подходят под задание. Простые задачи, такие как REST API заготовки или парсинг данных, теперь получают шаблонные ответы вместо функционально корректного кода.
Возможные триггеры: обновления, изменения модели или изменения в использовании?
Это сокращение связано с крупными обновлениями Codex, выпущенными в конце 2025 — начале 2026 года. Эти обновления были направлены на предотвращение рискованных предложений и расширение базы кода для поддержки большего числа языков, но также убрали узкие шаблоны кода, на которые полагались продвинутые пользователи. Когда обновление модели теряет поддержку логики крайних случаев, задачи, которые в прошлом году работали нормально, внезапно получают расплывчатые или неполные ответы. Разработчики, которые ежедневно используют Codex для быстрого прототипирования, особенно раздражёны: после обновления задача, которая раньше требовала двух запросов, теперь требует пяти или шести, если вообще работает. Добавьте к росту объёма пользователей и более строгих политиках согласования, и неудивительно, что многие говорят, что Codex стал глупее. Проблема не только в потере скорости; а в том, что инструмент «помнит», как вы работаете каждый день.
Отделение восприятия от реальности
- Если ваш кейс использования изменился (например, крупные проекты или новые языки), ожидается некоторый спад.
- Выплеск эмоций в сообществе, как темы на Reddit, может сделать регрессии более масштабными, чем они есть на самом деле.
- Когда ожидаешь более умных результатов, даже мелкие ошибки выглядят хуже; раздражение быстро накапливается.
Сейчас важно научиться проверять, действительно ли пострадал ваш рабочий процесс, а не просто ориентироваться на шум в интернете. Это следующий шаг.
Как определить, действительно ли Codex хуже выполняет ваши задачи?
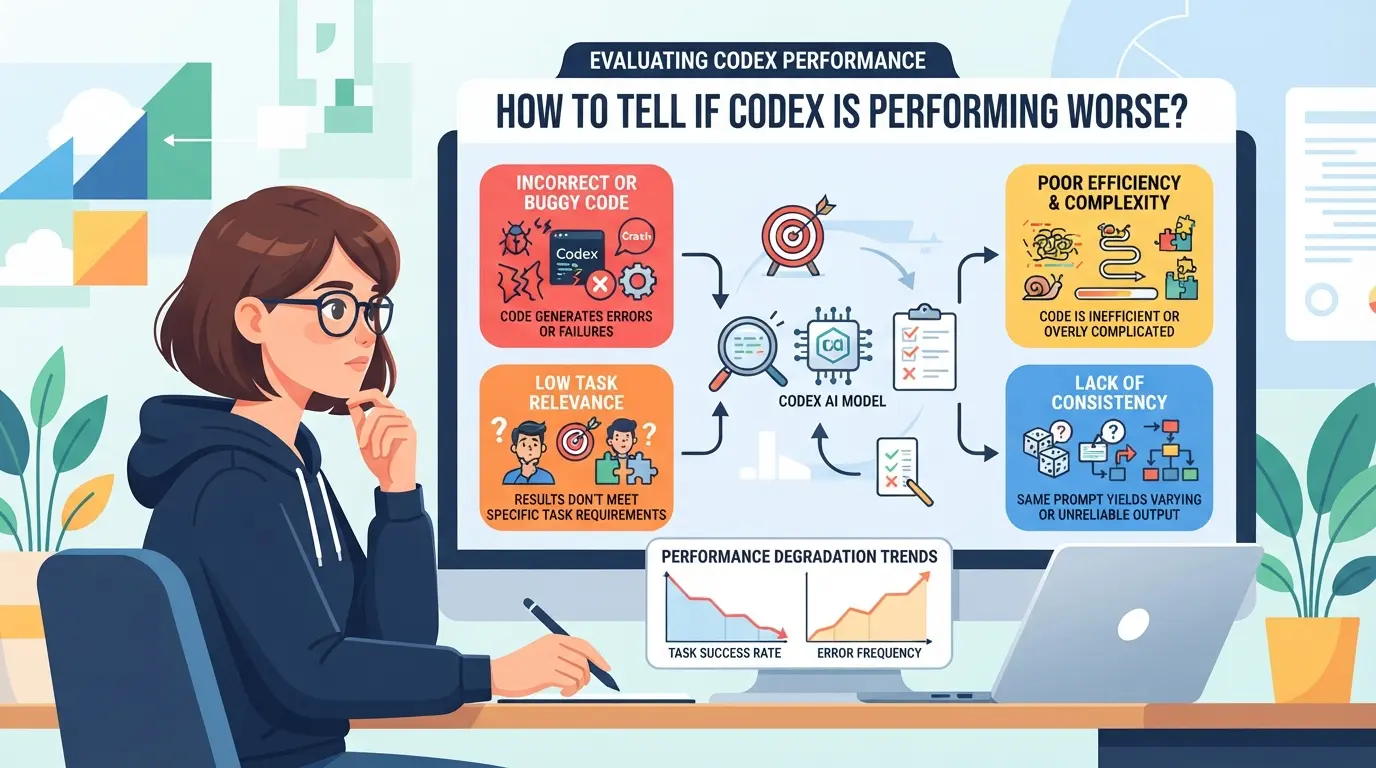
Если вы считаете, что Codex становится хуже, вам нужны доказательства, а не просто интуиция. Многие разработчики жалуются, что «кодекс стал глупее», но большинство никогда не запускает один и тот же запрос дважды и не отслеживает, что изменилось. Вот как проверить, действительно ли инструмент виноват в вашей нагрузке по программированию.
Настройка контролируемых тестов кода
Единственный способ узнать, снизилось ли качество Codex для ваших задач — это проводить параллельные тесты. Выбирайте набор подсказок, соответствующих вашей ежедневной работе, реальным исправлениям ошибок, рефакторингам или генерации шаблонных шаблонов. Вводите их в Codex и, если возможно, в старый релиз Codex или конкурирующую модель. Всегда используйте один и тот же контекст кода и настройки. Если вы не сохраняете одинаковые запросы, seed и окружение, нельзя винить Codex в случайных различиях.
Отслеживание регрессионных паттернов со временем
Если вы продолжаете видеть одни и те же сбои, пора их фиксировать. Регрессия обычно проявляется как повторяющиеся проблемы, а не случайные ошибки. Используйте этот мини-чек-лист, чтобы заметить реальные снижения:
- Сохраняйте все неудачные завершения с временной меткой и версией Codex.
- Отмечайте каждую проблему по языку, фреймворку или задаче (например, заглушка API, тестовый случай).
- Сравните новые ошибки с вашими старыми логами, этот же баг появился в прошлом месяце?
Когда винить Codex против Prompt Engineering
Легко подумать, что Codex сломался, когда на самом деле ваш запрос изменился или контекст стал более запутанным. Прежде чем обвинять модель, проверьте эти распространённые ловушки:
- Вы добавляли, удаляли или переставляли комментарии или блоки кода прямо перед запросом?
- Вы сейчас используете новый фреймворк, библиотеку или синтаксис, на котором Codex не был обучен?
- Вы сократили свой запрос или пропустили ключевой пример, который раньше видел Codex?
Если вы исправите ошибки в запросах, а тесты всё равно не работают, скорее всего, вы увидите реальную регрессию по Codex. Если нет, скорее всего, модель просто отвечает на более нечеткий запрос.
Следующий шаг — выяснить, что вызывает эти регрессии, обновления моделей, изменения данных или что-то ещё. Вот тут и начинают проявляться настоящие ответы.
Что заставляет инструменты для программирования ИИ, такие как Codex, становятся глупее?
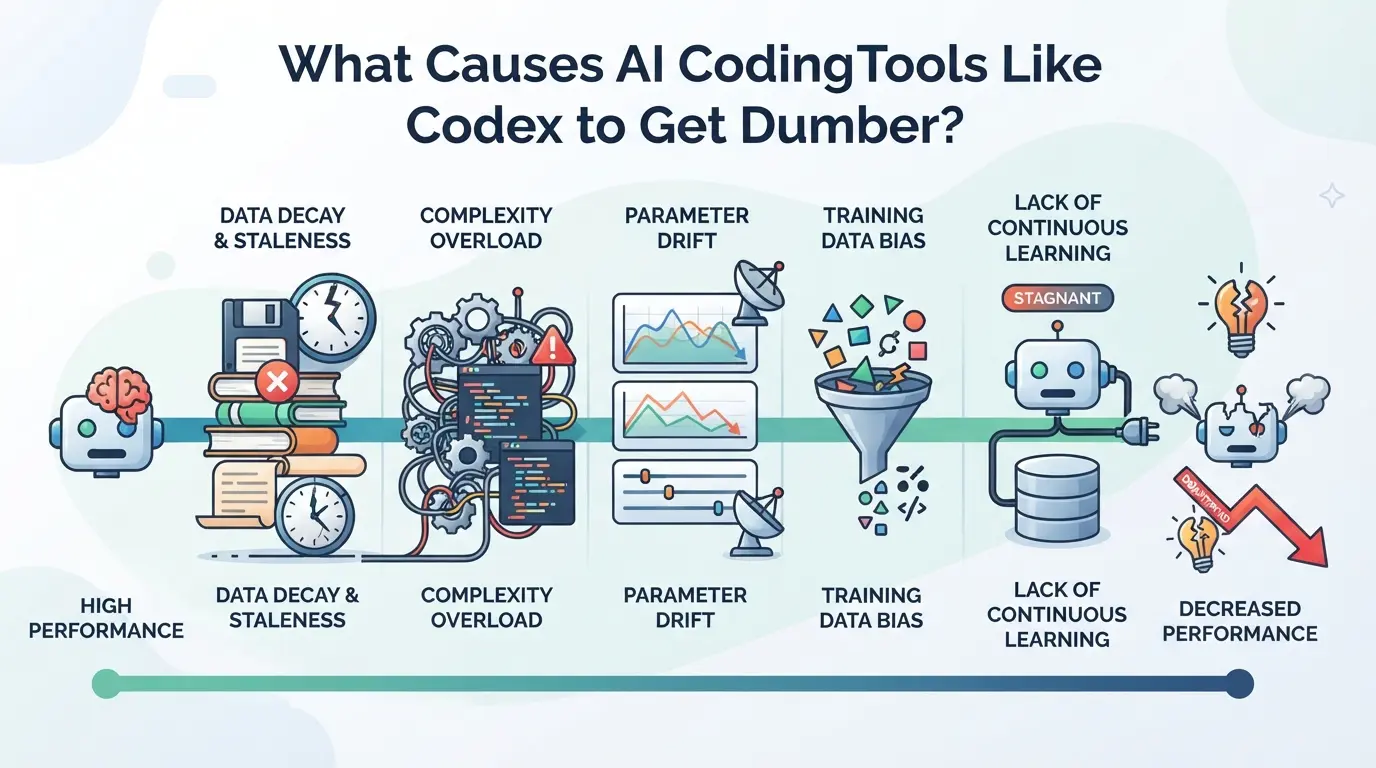
Большинство падений качества Codex связаны с изменениями за кулисами, новыми данными, более строгими правилами или техническими сокращениями. Редко это одна ошибка. Если вы заметили, что Codex стал глупее, вы видите побочные эффекты этих компромиссов.
Обновления моделей и сдвиги обучающих данных
Когда Codex переобучается с использованием новых данных, модель может потерять старые, нишевые шаблоны, которые раньше делали её острыми для крайних случаев. Попытки «повысить надёжность» часто приводят к тому, что система теперь усредняет разнообразный пользовательский код, поэтому уникальные или умные решения фильтруются. Вот почему ваши старые запросы теперь могут получать скучные, общие ответы.
Бизнес- и политические решения
Инструменты ИИ формируются не только инженерами, ими управляют команды по бизнес-рискам и комплаенсу. Обновления, призванные защитить Codex от жалоб на авторские права или оскорбительный контент, часто исключают целые примеры кода. Например, если компания ужесточает фильтры, чтобы избежать юридических проблем, вы внезапно получите больше отказов или расплывчатых советов вместо прямого завершения кода. Это становится ещё более вероятным, если инцидент с высокой видимостью заставит компанию ужесточить контроль по всем направлениям. Компромиссы здесь могут быть жёсткими: защита бренда иногда означает, что модель пропускает продвинутие, но чувствительные методы кода. Смещение ресурсов также может навредить: если компания перестанет уделять приоритет Codex, исправления ошибок могут быть медленнее или меньше инвестиций в качество моделей. Если ваш инструмент программирования на основе ИИ начинает уклоняться от вопросов, на которые раньше отвечал, это почти всегда признак того, что фильтры безопасности или политики стали ужесточене.
Технические проблемы с задолженностью и масштабированием
- Лаги инфраструктуры: если серверы не успевают, задержка растёт, а завершение кода усекается или отключается.
- Масштабирование упрощений: быстрый рост пользователей может заставить команду уменьшить размер модели или использовать более лёгкие версии.
- Тестирование пробелов: Поспешные релизы при сильном масштабировании часто пропускают глубокие регрессионные проверки, позволяя новым ошибкам появиться.
Эти факторы вместе объясняют не только падение производительности Codex, но и почему исправления не бывают быстрыми или предсказуемыми. Если вы видите больше ошибок или менее полезный код, это обычно связано с тем, что что-то изменилось на этапе, часто по причинам, выходящим за рамки инженерии.
Как адаптировать рабочий процесс написания кода, когда качество Codex падает
Если производительность Codex падает, решайте это напрямую: скорректируйте рабочий процесс, чтобы не терять время и не выпускать багованный код. Правильные изменения помогут вам оставаться продуктивным, даже если предложения становятся хуже.
Разнообразие вашего набора инструментов ИИ
- Попробуйте хотя бы один альтернативный помощник по программированию (например, Copilot, StarCoder или open-source модели). Если Codex не подходит, прямое сравнение — самый быстрый способ понять, подходит ли что-то другое для вашего стека.
- Объединяйте AI-инструменты со стандартным IDE или линтером. Не просто меняйте инструменты — запускайте оба параллельно. Это поможет заметить проблемы со стилем или пропущенную логику, которые часто появляются в AI-выходах.
- Задокументируйте, какой инструмент или комбинация решает ваши настоящие проблемы. Ведите простой журнал: «Копилот лучше с рефакторингом, Кодекс лучше в docstrings.» Это избавляет вас от переключения между инструментами без плана.
- Следите за резкими падениями в любом инструменте. Тот же цикл обновлений, который ухудшил Codex, может затронуть и других, поэтому держите альтернативы в готовности.
Улучшение процессов быстрого инжиниринга и проверки
- Когда Codex начинает терять суть, сокращайте свои подсказки. Используйте конкретные функциональные сигнатуры, приводите тестовые случаи и версии на языке состояния — это сужает фокус ИИ.
- Всегда проверяйте сгенерированный код перед запуском, особенно в крайних случаях. Если раньше предложения Codex «просто работали», а теперь не проходили тесты, предполагайте, что каждый выход требует более внимательного рассмотрения.
- Если у вас постоянно получается слабый или не по цели код, перепишите запрос и запустите заново. Такое небольшое изменение, как «использовать синтаксис Python 3.10», может заставить ответить лучше.
- Сочетайте ручной анализ кода с AI-выводом. Даже если обзор замедляет вас, это экономит часы на тихих логических ошибках.
Управление многоаккаунтными или многоокружительными настройками
- Настройте отдельные профили браузера или песочницы для каждого AI-инструмента или аккаунта Codex. Это сохраняет чистоту вашей работы и истории инструментов, чтобы если один инструмент регрессирует, остальные не загрязняются.
- Отслеживайте, какая среда и логин вызвали каждое крупное изменение кода. Если появляется баг, вы будете знать, какой инструмент её создал, а не только какая строка сломалась.
- Если вы заметили странное поведение, например, код, который компилируется, но не работает во время выполнения, проверьте, не поступил ли он из инструмента под другим аккаунтом. Перекрёстное загрязнение — реальный риск при смене инструментов.
- Меняйте окружения, если начинают лагать или ошибаться. Иногда простое переход на новый профиль исправляет «застряли» сессии ИИ, которые возвращают устаревшие или повторяющиеся предложения.
Как безопасно разделять среды для программирования и учетные записи при использовании нескольких инструментов ИИ
Риски смешивания аккаунтов и сессий
Смешивание сессий кода или аккаунтов AI-инструментов в одном профиле браузера может раскрывать файлы cookie, раскрывать ключи API или запускать предупреждения платформы. История перекрёстного входа — частая причина, по которой пользователи внезапно получают помеки или ограничение скорости.
Лучшие практики изоляции окружающей среды
Используйте отдельные профили браузера, а лучше — отдельные браузеры для каждого кодингового аккаунта или инструмента. Назначьте уникальный прокси для каждого профиля, если вы выполняете чувствительные или региональные задачи. Это предотвращает распространение данных сессий и сетевых отпечатков между средами.
Когда стоит рассматривать продвинутые инструменты для изоляции
- Вы управляете 3+ инструментами ИИ или несколькими пользователями в день
- Вы работаете в команде с общими устройствами или профилями
- Начинают появляться блокировки платформы или повторные запросы на верификацию
Как использовать DICloak для изолированных сред кодирования и конфигурации прокси
Если нужно действительно разделять сессии кода или аккаунты платформы, особенно после того, как вы заметили такие проблемы, как ухудшение кодекса или снижение качества ИИ, специфичные для платформы, DICloak предоставляет командам структурированный способ изоляции сред и выходов из сети. В этом разделе показано, как операторы могут использовать DICloak для настройки отдельных профилей браузера и настройки пользовательских прокси для каждого инструмента или аккаунта без риска пересечения или совместных сигналов.
Настройка отдельных профилей браузера и конфигурация отпечатков пальцев в DICloak
Операторы могут создать новый профиль браузера в DICloak для каждой среды или учетной записи, а затем настроить настройки отпечатков пальцев, такие как User Agent, операционная система, часовой пояс и разрешение экрана, чтобы соответствовать предполагаемому сценарию использования. Этот рабочий процесс полностью разделяет хранение и сигналы идентификации браузера между сессиями, поэтому переключение между инструментами ИИ или аккаунтами платформы не размывает границы. Область ограничена изоляцией на уровне браузера; она не меняет подключённый инструмент кодирования и не управляет аккаунтами. 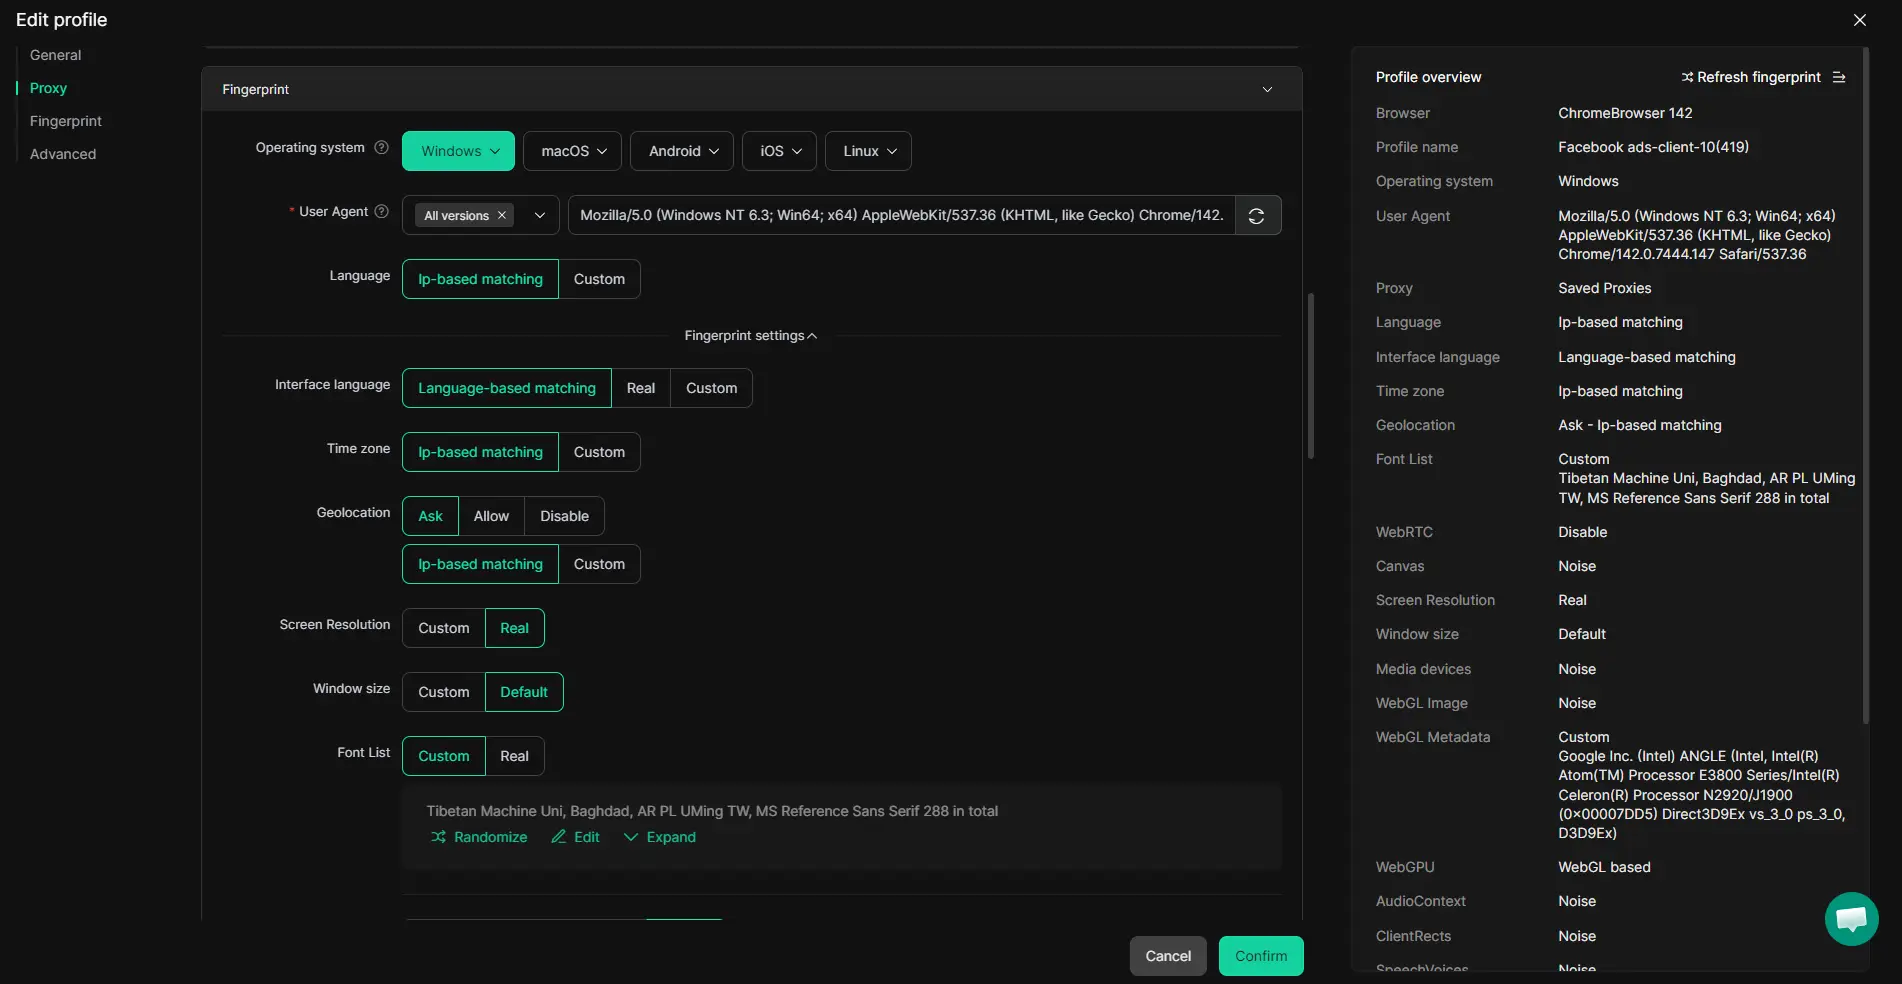
Настройка пользовательских прокси для каждого профиля
Для рабочих процессов, где разные аккаунты или сессии кода требуют собственного выхода из сети, операторы могут настроить отдельное прокси-соединение для каждого профиля DICloak. Вы можете ввести свои собственные данные прокси, протестировать их непосредственно в настройках профиля и подтвердить местоположение сети перед использованием этого профиля для программирования. DICloak хранит эти настройки для каждого профиля, но никогда не продаёт и не предоставляет прокси, выбор и качество остаются вашей ответственностью. 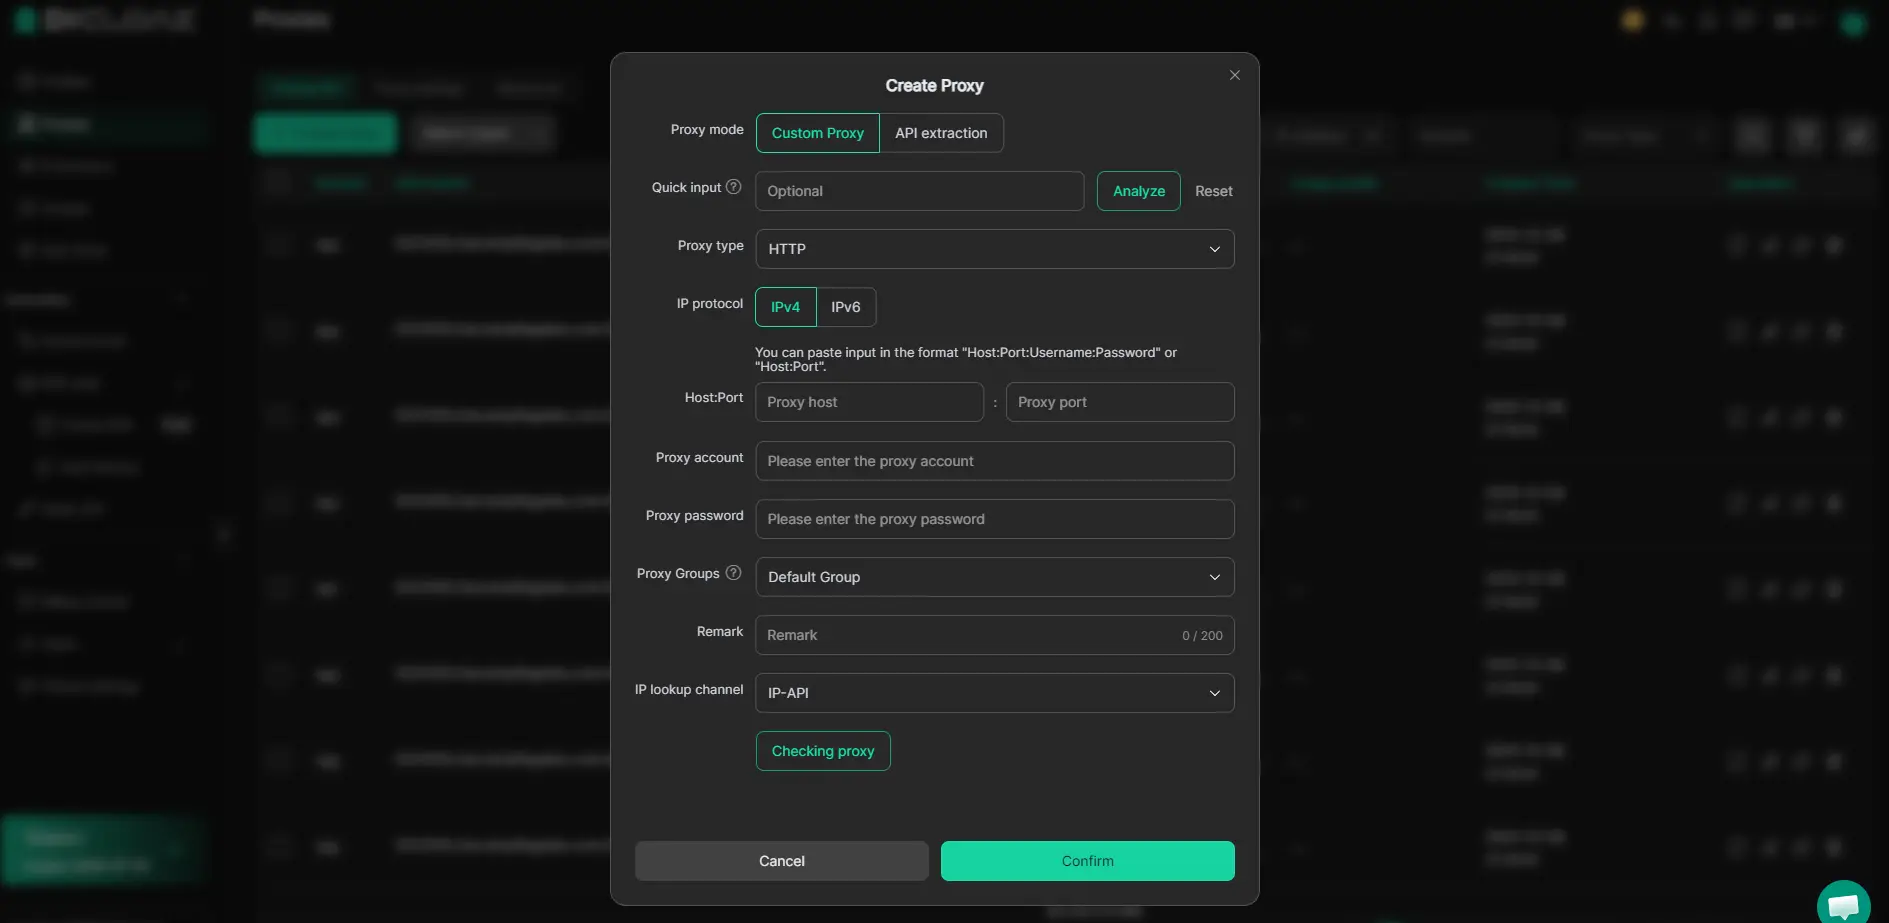
Если вы пропустите эти этапы настройки, утечки между аккаунтами могут незаметно появиться, далее мы расскажем о распространённых ошибках и способах их избежать.
Распространённые ошибки при реагировании регрессии Кодекса (и как их избежать)
Многие разработчики, заметившие регрессии в Кодексе, реагируют слишком быстро или пропускают проверки клавиш, что усугубляет ситуацию. Вот где люди ошибаются и как увернуться от привычных ловушек.
Поспешные выводы без тестирования
Легко предположить, что «кодекс стал глупее» означает постоянный ухудшение, но пропуск базовой диагностики — пустая трата времени. Большинство сбоев связаны с опечаткой в подсказке, отсутствием контекста или беззвучным обновлением модели, тестирование с проверенным подсказкой может сэкономить часы.
Игнорирование безопасности и соответствия требованиям при смене инструментов
- Никогда не используйте пароли или API-ключи в новых инструментах ИИ.
- Проверьте условия каждого инструмента перед подключением рабочих аккаунтов.
- Ведите лог, какие учетные данные и данные компании используются в каждой среде.
Чрезмерное усложняние рабочего процесса
Использование трёх новых инструментов одновременно часто приводит к путанице и утечкам. Перед добавлением нового инструмента проверьте:
- Можете ли вы определить, какая сессия какая, на панели задач?
- Ваши папки с проектами чётко разделены по инструментам?
- Вы фиксировали, какой инструмент использовался для каждого git-коммита?
Когда стоит придерживаться кодекса, переключать инструменты или комбинировать подходы
Если вы спрашиваете, стоит ли переждать падение качества кодирования кодекса или уйти, начните с того, чтобы подбирать проблему под свои реальные потребности в рабочем процессе, а не только с уровнем раздражения. Понижение вершины инструмента кажется личным, но правильный шаг зависит от риска и того, насколько срыв действительно замедляет вас.
Признаки того, что стоит остаться с Codex
| Сценарий |
Оставайтесь с Кодексом |
Почему это логично |
| Регрессия незначительная/временная |
Да |
Небольшие падения часто проходят после обновлений |
| Альтернативы нарушают рабочий процесс |
Да |
Переключение может занять больше времени, чем сэкономить |
| Некритический код, низкий риск |
Да |
Если ошибки легко исправить, маленькие капли болят меньше |
Если дроп раздражает, но не блокирует, обычно разумнее дождаться исправления, чем полностью перерабатывать весь стек.
Когда переходить или дополнять другие инструменты
Когда Codex начинает давать сбой в основных рабочих процессах или вы находите другой инструмент, настроенный под ваш стек или язык, переключение становится менее болезненным путём. Постоянные ошибки, блокирующие проекты — это красная черта, не тратьте дни на надежду на исправление, которое не появится.
Смешивание нескольких инструментов для максимальной продуктивности
Смешивание инструментов лучше всего работает, когда вы отслеживаете, какой ассистент обрабатывает какой тип кода, а не просто сбрасывайте все задачи на каждый ИИ. Ведите записи, где ломается, чтобы вы могли направлять запросы к инструменту, который действительно доставляет запросы. Это позволяет избежать двойной работы и поддерживает движение продакшена.
Часто задаваемые вопросы о кодексе стали глупее
Codex действительно становится глупее, или это только мой опыт?
Чтобы понять, связано ли это с «кодексом глупее» только у вас или это настоящая проблема, сравните свои недавние результаты с более старыми примерами по тем же задачам. Если заметите больше ошибок или меньше полезных советов, посмотрите на онлайн-форумы для похожих жалоб. Иногда изменения или обновления рабочих процессов в вашей среде тоже могут повлиять на результаты, а не только на саму модель Codex.
Что делать, если Codex внезапно ухудшит мои основные задачи по программированию?
Во-первых, попробуйте использовать Codex с простыми, понятными подсказками, чтобы понять, связана ли проблема с вашим текущим проектом. Протестируйте в другом браузере или устройстве. Проверьте актуальные обновления в ваших инструментах для программирования или в самом Codex. Если спад продолжится, подумайте о том, чтобы поделиться отзывами с OpenAI и поискать обходные пути, которые нашли другие.
Может ли использование прокси или отдельных профилей браузера улучшить производительность Codex?
Прокси и отдельные профили браузера помогают разделять ваши рабочие и личные проекты. Они не улучшают качество основного кодирования Codex и не решают регрессию AI в кодексе. Эти инструменты могут упростить диагностику, изолируя переменные, но не исправят реальное падение производительности Codex.
Есть ли риски при переходе между несколькими инструментами для программирования ИИ?
Да, использование нескольких инструментов для кодирования на базе ИИ может запутать ваш рабочий процесс и увеличить вероятность путаницы данных. Риски безопасности и соответствия также возрастают, если вы обмениваетесь чувствительным кодом или учетными данными между платформами. Всегда проверяйте настройки конфиденциальности и условия использования каждого инструмента перед переходом.
Как мне защитить свои аккаунты и программистские среды, используя несколько инструментов ИИ?
Используйте отдельные аккаунты и профили браузера для каждого инструмента. Никогда не делитесь паролями или токенами между ними. Храните учетные данные в менеджере паролей. Регулярно выходите из аккаунта и очищайте куки. Избегайте загрузки чувствительного кода, если не доверяете безопасности платформы. Всегда проверяйте настройки разрешений в ваших средах.
Учитывая эти недавние изменения, сейчас хороший момент пересмотреть свои текущие инструменты и найти решения, которые лучше соответствуют вашим потребностям рабочего процесса. Если вы готовы исследовать альтернативы, которые поддерживают вашу продуктивность, попробуйте DICloak. Попробуйте DICloak бесплатно
 Бесплатные инструменты
 Плагин Cookie
 Генератор UA
 Генератор MAC-адресов
 Генератор IP-адресов
 Список IP-адресов
 Генератор кода 2FA
 Мировые Часы
 Проверка анонимности
 WebRTC Leak Test
 Генератор UUID
 Проверка прокси
 Проверка FB Рекламы
 AI-веб-скрейпинг
 Бесплатные SMM-инструменты
 Проверщик теневой блокировки Twitter
 Проверка имени в Instagram
 UTM-генератор
 Генератор username
 AI генератор хэштегов
 Генератор заголовков LinkedIn
 Размер изображений для соцсетей